Um plano de resposta a incidentes cibernéticos define decisões, responsáveis e procedimentos para manter os serviços essenciais funcionando enquanto a empresa contém o ataque e recupera o ambiente de TI.
Um ataque cibernético se espalha antes que a equipe compreenda o ocorrido. Por isso, restaurar os sistemas e aguardar o retorno da rotina não atende à necessidade real. A empresa precisa identificar o que preservar, definir quem decide, indicar os processos operacionais manuais e determinar o ambiente seguro de recuperação.
A matéria da Harvard Business Review sobre as primeiras 72 horas após um ataque cibernético reforça essa mudança de perspectiva. A liderança não deve buscar a recuperação simultânea de toda a infraestrutura. A prioridade consiste em garantir a operação do núcleo do negócio até que o ambiente volte a ser confiável.
Por que um plano de 72 horas é diferente de um plano de continuidade?
Um plano tradicional de continuidade costuma partir da ideia de que os sistemas serão restaurados rapidamente e voltarão a ser confiáveis. Em uma crise cibernética, essa premissa pode estar errada: os dados podem ter sido alterados, os sistemas podem estar comprometidos e o invasor pode ainda manter acesso ao ambiente.
A pesquisa apresentada pelos autores da HBR foi realizada com 1.000 executivos seniores de 20 setores em 13 países. Segundo o estudo, 73% dos executivos ainda acreditam que abordagens baseadas em “prever e controlar” são suficientes para lidar com ataques. Ao mesmo tempo, 81% esperam restaurar sistemas críticos em até dez dias, enquanto a análise de casos reais citada pelos autores aponta uma recuperação mediana de três a seis meses.
Essa diferença entre expectativa e realidade muda a pergunta que a liderança deve fazer. Em vez de perguntar apenas “quando todos os sistemas estarão de volta?”, a empresa precisa responder: “quais resultados não podem parar enquanto o ambiente digital não é totalmente confiável?”.
Qual é o impacto financeiro de cada hora de indecisão?
O custo de um ataque não depende apenas dos dados criptografados ou do valor de um eventual resgate. A interrupção da operação pode comprometer vendas, entregas, atendimento, folha, contratos, produção e relacionamento com clientes.
Uma forma simples de estimar o impacto é calcular o custo-hora da indisponibilidade: receita ou margem perdida + pessoal improdutivo + penalidades contratuais + despesas emergenciais de recuperação. O número real varia por empresa, mas essa conta ajuda a levar a discussão para o conselho e para a diretoria.
A HBR também destaca que a interrupção dos negócios representa mais da metade das reclamações relacionadas a ataques cibernéticos. Isso explica por que o plano precisa priorizar a continuidade do serviço, e não apenas a restauração técnica.
Quais são as cinco etapas de um plano para as primeiras 72 horas?
1. Defina o núcleo operacional essencial
Comece por resultados de negócio, em vez de uma lista de servidores. Para isso, pergunte a cada área: se os aplicativos ficarem fora do ar por 72 horas, quais interrupções provocariam o maior dano? A partir dessa resposta, você consegue indicar as prioridades, definir procedimentos manuais, nomear responsáveis e determinar o momento exato de migrar para um ambiente de recuperação.
2. Predefina as decisões que determinam a recuperação
Durante um ataque, a demora costuma surgir de perguntas que ninguém respondeu antes. Por isso, o ponto de travamento não é técnico: a equipe hesita porque não sabe quem pode isolar uma unidade, autorizar a suspensão de um serviço ou definir a ordem de restauração dos sistemas.
Para piorar esse cenário, a incerteza se reflete também na gestão de crise. Sem um fluxo predefinido, a liderança perde tempo precioso tentando descobrir quando acionar o jurídico, a comunicação, o seguro cibernético, os clientes e as autoridades.
3. Mapeie as dependências que podem interromper a operação
Uma aplicação crítica raramente funciona sozinha. Ela pode depender de identidade, DNS, internet, telefonia, provedor de nuvem, fornecedor de software, integrações, dados de terceiros e ferramentas de comunicação.
A pesquisa citada na HBR informa que 69% das organizações dependem cada vez mais de ecossistemas digitais complexos, mas apenas 38% afirmam ter uma visão clara das interconexões críticas. Uma dependência oculta pode alcançar áreas que pareciam protegidas.
O mapeamento deve registrar o serviço de negócio, suas dependências, responsáveis, alternativas e ordem de recuperação. Essa visibilidade revela pontos únicos de falha antes da crise.
4. Crie um ambiente limpo para executar o núcleo essencial
Depois de um ransomware ou de um ataque destrutivo, o ambiente de produção pode não ser confiável. Sistemas que parecem intactos podem ter sido comprometidos antes da detecção. Restaurar aplicações sem validar sua origem pode reinfectar a operação.
A orientação da CISA recomenda isolar imediatamente os sistemas afetados, priorizar os ativos críticos e preservar evidências. Além disso, a norma orienta o uso de canais de comunicação fora do ambiente possivelmente comprometido.
Paralelamente, para erguer um ambiente de recuperação limpo, a equipe deve partir de backups protegidos, imutáveis e testados. Afinal, a meta principal é disponibilizar primeiro os serviços, dados e canais necessários para garantir a confiança, a continuidade do negócio e a conformidade regulatória.
Nesse ponto, uma estratégia de Disaster Recovery preparada para ataques de ransomware é diferente de manter cópias de arquivos. Ela precisa estabelecer onde a operação será recuperada, em que ordem e com quais critérios de segurança.
5. Teste o plano em cenários reais e atualize-o
Documentação não prova que a empresa consegue se recuperar. O teste precisa simular decisões, indisponibilidade de sistemas, falhas de comunicação, dados suspeitos e pressão sobre a liderança.
Segundo a matéria da HBR, apenas 35% das organizações realizam regularmente exercícios reais de recuperação e continuidade. O restante depende principalmente de auditorias e documentos que podem estar desatualizados.
Um exercício útil testa quem decide, quais serviços voltam primeiro, como as áreas trabalham sem suas ferramentas, como a empresa se comunica e como valida que o ambiente restaurado está limpo.
Quais falhas práticas fazem o plano quebrar?
O plano costuma falhar em situações previsíveis: backup nunca restaurado, contatos desatualizados, comunicação dentro da rede comprometida, credenciais compartilhadas entre produção e cópias de segurança e dependências de fornecedores que nunca foram mapeadas.
Como reduzir o tempo de resposta antes do ataque?
O tempo de resposta diminui quando a empresa combina visibilidade, autoridade e capacidade de recuperação. Isso envolve monitorar endpoints, rede e identidades; revisar vulnerabilidades; definir contatos de escalada; testar procedimentos manuais; validar backups e exercitar a liderança.
A pesquisa de prontidão da Sygnia reforça esse ponto. Em 2026, 73% das organizações pesquisadas disseram não se sentir preparadas para suportar um ataque sem interrupção do negócio. Menos de 40% consideraram suas capacidades de resposta altamente eficazes, e 90% esperavam dificuldades para coordenar as partes interessadas durante um incidente significativo.
Esses dados mostram por que o plano deve incluir segurança, TI, operações, jurídico, comunicação, diretoria e, quando aplicável, o conselho. O ataque pode começar em um endpoint, mas o impacto se espalha por decisões de negócio.
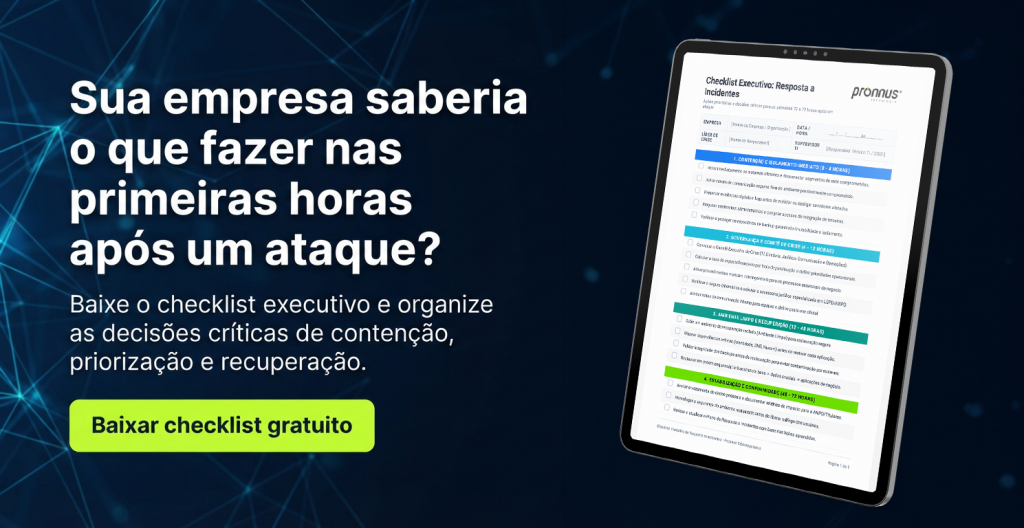
Sua empresa saberia responder, hoje, quem pode isolar um sistema, qual processo manual será ativado e qual serviço deve voltar primeiro? Se a resposta depender de uma reunião improvisada, o próximo passo é testar o plano antes que um invasor o faça por você. Nossa estrutura de segurança da informação reúne proteção de rede, endpoints, vulnerabilidades, backup e recuperação para apoiar essa avaliação.
Como o Disaster Recovery protege a continuidade?
O Disaster Recovery transforma prioridades de negócio em uma sequência de recuperação, com objetivos de tempo, dependências, ambiente de failover e critérios para liberar cada sistema.
Backup e recuperação cumprem funções diferentes. O backup preserva versões dos dados; o Disaster Recovery organiza a retomada de servidores, aplicações e processos. Quando as cópias ficam na mesma infraestrutura comprometida, o ransomware pode destruí-las primeiro.
Por isso, a arquitetura deve considerar isolamento, imutabilidade, criptografia, testes de restauração e monitoramento de integridade. O artigo da Pronnus sobre a diferença entre ter cópias e ter continuidade aprofunda essa relação entre proteção de dados, RTO e continuidade operacional.
O que a LGPD muda na resposta ao incidente?
A LGPD acrescenta responsabilidade à resposta técnica. Se dados pessoais forem acessados, alterados, perdidos ou ficarem indisponíveis, a empresa precisa avaliar o incidente, registrar decisões e analisar a necessidade de comunicação conforme o caso e as orientações da ANPD.
Isso exige preservar evidências, controlar quem acessa os dados durante a crise e envolver as áreas responsáveis por privacidade, jurídico e governança. A organização também deve conseguir demonstrar que adotava medidas técnicas e administrativas compatíveis com o risco.
A análise jurídica depende da natureza do incidente, dos dados afetados e das circunstâncias específicas. Por isso, o plano deve definir previamente quem conduz essa avaliação e como a informação será documentada.
Como a Pronnus ajuda a encurtar a resposta?
A Pronnus atua sobre as etapas que mais influenciam o tempo de resposta: identificar riscos, proteger ativos, detectar ameaças, responder ao incidente e recuperar dados e sistemas.
Na prática, isso pode envolver firewall gerenciado, proteção de endpoints, gerenciamento de vulnerabilidades, atualizações, backup corporativo, monitoramento e Disaster Recovery. A combinação reduz pontos cegos, protege as cópias de segurança e dá à empresa uma base mais confiável para decidir o que recuperar primeiro.
A tecnologia só ajuda a encurtar a recuperação quando está associada a responsáveis definidos, dependências conhecidas, procedimentos testados e objetivos de tempo compatíveis com a operação.
Sua empresa sobreviveria às primeiras 72 horas?
A pergunta não é se todos os sistemas podem ser restaurados imediatamente. É se a empresa sabe manter seus resultados essenciais enquanto investiga, contém e recupera o ambiente.
Se ainda existem dúvidas sobre quem decide, quais sistemas são prioritários, onde estão as cópias limpas ou quanto tempo levaria para voltar a faturar, o plano precisa ser testado.
Fale com nossos executivos para avaliar as lacunas de segurança, backup, monitoramento e recuperação da sua operação antes que um incidente transforme incerteza em paralisação.
FAQ
Isole os sistemas afetados de forma coordenada, preserve evidências, acione o plano de resposta, use comunicação fora da rede comprometida e priorize os serviços essenciais. Evite restaurar sistemas antes de validar que o ambiente está limpo.
Não. O backup preserva dados, mas a resposta também exige contenção, investigação, prioridades, ambiente limpo, responsáveis e procedimentos de recuperação testados.
Esse período concentra decisões que limitam a propagação do ataque e definem a continuidade da operação. Quanto mais tempo a empresa leva para isolar, priorizar e decidir, maior tende a ser o impacto operacional.
TI e segurança conduzem a parte técnica, mas operações, diretoria, jurídico, comunicação, privacidade, fornecedores e seguro cibernético também podem precisar participar das decisões.
Realize exercícios com cenários reais: sistemas indisponíveis, dados suspeitos, comunicação limitada e pressão por decisão. Teste a restauração, os procedimentos manuais, os contatos, o ambiente limpo e a ordem de prioridade.